Jedes Wort kostet. Auch das Höfliche.
Diese Woche hab ich im Professional Scrum Product Owner – AI Essentials Training neben vielen anderen guten Fragen auch diese bekommen: Kosten eigentlich auch die Antworten der KI Geld? Oder nur meine Fragen?
Kurze Antwort: Ja. Und zwar mehr.
Wer KI über die API nutzt, zahlt pro Token. Das gilt für alles, was reingeht (Input), und für alles, was rauskommt (Output). Und der Output ist teurer. In Anthropics Preistabelle kostet ein Output-Token bei den Modellen, die ich nachgeschaut habe, das Fünffache eines Input-Tokens.
Und mit Abo? Da zahlst Du pauschal. Die Tokens laufen trotzdem mit, nur eben nicht in Euro, sondern in Nutzungslimits. Wer schon mittags “Limit erreicht” sieht, weiss, wovon ich rede.
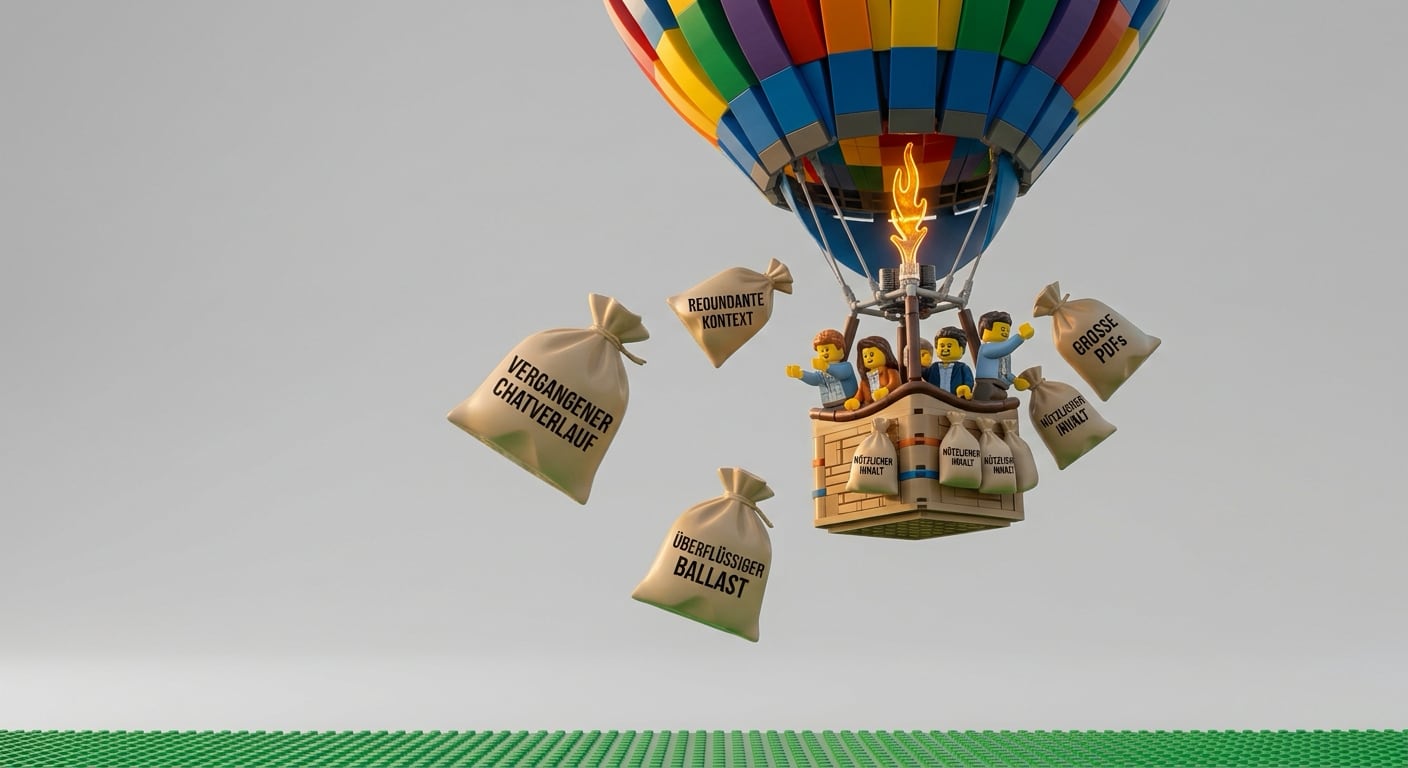
Jetzt kommt der Haken, den man verstehen muss: In einem Chat schickt das Tool bei jeder neuen Nachricht den kompletten bisherigen Verlauf wieder mit. Eine ausschweifende Antwort zahlst Du also nicht einmal. Du zahlst sie bei jeder Folgefrage aufs Neue. (Und wenn das Modell vorher “nachdenkt”, zählt das auch mit, selbst wenn Du davon nichts siehst.)
Kommt Dir bekannt vor? Eines der Prinzipien hinter dem Agilen Manifest sagt es so: “Simplicity – the art of maximizing the amount of work not done – is essential.” Gilt offenbar auch für Maschinen :-).
Für alle, die im Chat arbeiten:
- Machs kurz: Sag, wie lang die Antwort sein soll. “Max. 5 Sätze” wirkt spürbar besser als “bitte kurz”.
- Neues Thema, neuer Chat. Sonst reist der alte Verlauf als Ballast mit.
- Nicht jede Frage braucht das grösste Modell. Zum Umformulieren oder Zusammenfassen reicht oft ein kleineres.
- Lad nur hoch, was gebraucht wird. Das 80-seitige PDF für eine Frage zu Seite 12? Na…
Für alle, die mit der API bauen:
- Erst messen. Jede API-Antwort sagt Dir, wie viele Tokens sie verbraucht hat. Optimier dort, wo es wirklich teuer ist.
- Prompt Caching: Wiederkehrende Teile wie Systemprompt oder Dokumente werden zwischengespeichert. Ein Cache-Treffer kostet laut Anthropic nur ein Zehntel des normalen Input-Preises.
- Batch API: Alles, was nicht sofort fertig sein muss, läuft mit 50 % Rabatt auf Input und Output.
- max_tokens setzen. Als Deckel, damit keine Antwort ausufert.
- Klein vorsortieren: Ein günstiges Modell entscheidet, ob eine Anfrage überhaupt das teure Modell braucht.
Eine Warnung an die Optimierer unter Euch: Kürz nicht so lange, bis die Qualität kippt. Drei Nachfragen kosten mehr als eine gute Antwort.
Probier’s aus: Schau Dir Deinen letzten langen Chat an. Wie viel davon hast Du wirklich gebraucht?
Zum Nachschlagen: Anthropic Preisübersicht (auf Deutsch)
Cheers.